[이 기사에 나온 스타트업에 대한 보다 다양한 기업정보는 유니콘팩토리 빅데이터 플랫폼 ‘데이터랩’에서 볼 수 있습니다.]
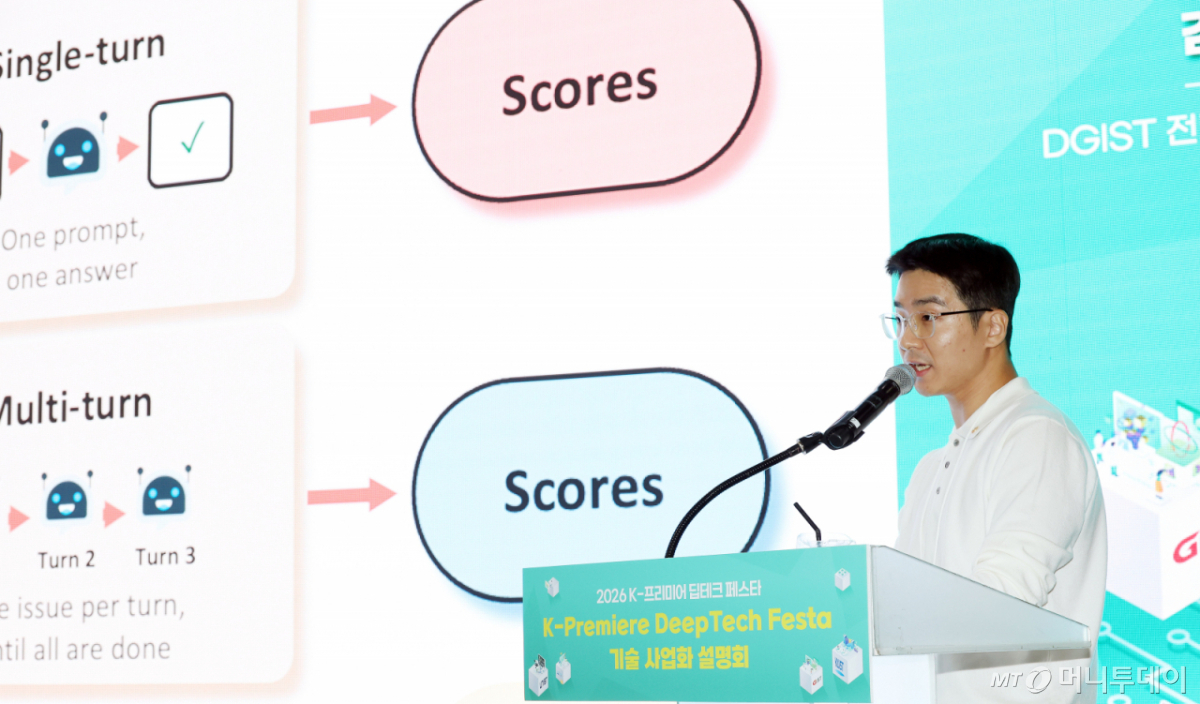
"AI가 코딩을 잘한다는 것과 그 코드를 우리가 100% 믿는다는 건 별개의 이야기입니다."
김기섭 DGIST(대구경북과학기술원) 전기전자컴퓨터공학과 교수가 29일 서울 삼성동 코엑스에서 열린 '2026 K-프리미어 딥테크 페스타'에서 코딩 AI의 신뢰성을 검증한 연구 결과를 발표하며 이같이 말했다. 코드를 평가하는 AI는 같은 코드라도 제시 순서나 화면 표현만 바꾸면 판단이 뒤집혔고, 코드를 고치는 AI는 문제가 여러 개인 코드에서 지시받은 문제만 고쳤다. 김 교수는 AI가 언제, 왜 실패하는지 이해해야 성능을 제대로 끌어올릴 수 있다고 강조했다.
김 교수는 이미지를 이해하는 비전언어모델(VLM)이 코드 캡처 이미지를 보고 어느 코드가 더 읽기 쉬운지 평가하는 상황을 다루면서 코드의 순서를 바꾸자 평가 방식도 달라지는 걸 관측했다. 코드 내용은 그대로 두고 다크모드, 글꼴, 색상 같은 화면 표현만 바꿔도 판단이 뒤집혔다. 김 교수는 "AI는 코드를 평가할 수 있지만 그 판단이 언제 일관되고 무엇에 영향을 받는지는 추가 검증으로 확인해야 한다"고 설명했다.
코드를 수정하는 AI의 경우 기존에는 문제 하나를 얼마나 잘 고치는지만 봤다. 실제 소프트웨어에는 불필요한 코드, 오래된 문법, 잘못된 로직 등 여러 가지 문제가 함께 섞여 있다. 연구팀은 실제 오픈소스 프로젝트에서 모은 약 600개 함수에 여러 코드 품질 문제가 동시에 있도록 만든 평가 데이터 '컴파운드벤치(CompoundBench)'를 새로 구축했다.
거대언어모델(LLM) 9종에 한 번에 고치기, 여러 번 반복해 고치기, 문제 위치를 알려주고 고치기 등 세 방식을 적용했다. 하나만 고치라는 지시를 받은 AI는 정말 하나만 고쳤다. 김 교수는 "말을 너무 잘 들어서 문제가 생긴다"고 말했다. 똑똑한 모델일수록 지시를 충실히 따르면서 전체 문제 해결 성적은 오히려 낮았다. 반복 수정은 성능을 어느 정도 높였지만, 반복 횟수만큼 비용이 두세 배씩 늘었다.
가장 효과가 큰 방식은 문제의 위치와 종류를 알려주는 것이었다. 줄 번호와 수정 제안이 담긴 코드 검사 보고서를 함께 주자 가장 성능이 좋은 프런티어 모델은 함수의 약 93%를 완벽하게 고쳤다. 문제 유형별로 특화한 AI를 모아 배정하는 방식도 시험했지만, 분석 도구가 찾아낸 문제를 정확히 알려주는 방식이 더 나았다. 김 교수는 "좋은 모델을 고르는 것만으로는 충분하지 않고 무엇을 고치라고 지시하고 어떤 정보를 보여주는지도 그만큼 중요하다"고 말했다.
연구팀은 코드 평가와 수정을 하는 AI 내부도 들여다봤다. LLM 안에 파이썬, 자바, C++ 등 프로그래밍 언어별로 담당 뉴런이 따로 있는지 확인하기 위해 다섯 개 언어와 관련된 뉴런을 찾아 꺼봤다. 연구팀이 제안한 방식은 기존 방식보다 약 70% 적은 뉴런을 골라내고도 목표 언어에 미치는 영향을 기존 방식의 약 91% 수준으로 유지했다. 그러나 다른 언어에 미치는 악영향도 약 93% 그대로 남았다. 특정 언어에 중요한 뉴런이 그 언어에만 쓰이는 건 아니었다는 뜻이다.
성능 점수만으로는 보이지 않는 변화도 있었다. 일부 뉴런을 껐을 때 C++ 코드 생성 성공률은 약 1.8%포인트 떨어지는 데 그쳤지만 문법·컴파일 오류는 약 11%포인트 늘었다. 여러 언어에 공통으로 중요한 뉴런은 그대로 두고 나머지만 조절하자 목표 언어에 대한 효과는 상당 부분 유지하면서 다른 언어의 성능 손실을 약 55% 줄였다. AI에 파이썬을 추가 학습시키면서 이미 익힌 자바 실력을 지키는 데 활용할 수 있는 결과다.
김 교수는 "앞으로 AI 연구는 높은 성능을 달성하는 것을 넘어 AI가 언제, 왜, 어떻게 실패하는지 이해하고 이를 바탕으로 성능을 끌어올리는 방향으로 가야 한다"고 말했다.
한편 이날 행사에서는 KAIST·DGIST·UNIST·GIST 등 4대 과학기술원의 주요 연구 성과가 소개됐다. 행사에서는 기술 발표와 함께 수요기업과 각 과학기술원 교수·연구자 간 일대일 상담 및 컨설팅도 진행됐다.
독자들의 PICK
지금 5,254명 읽는 중