[이 기사에 나온 스타트업에 대한 보다 다양한 기업정보는 유니콘팩토리 빅데이터 플랫폼 ‘데이터랩’에서 볼 수 있습니다.]
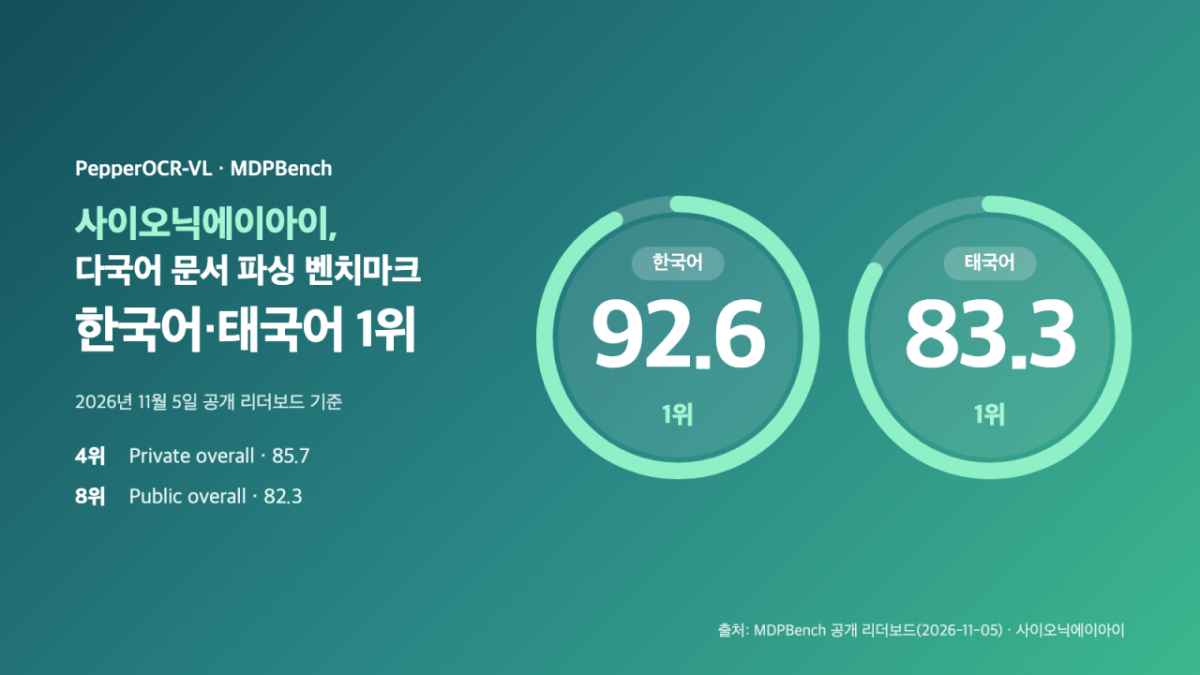
기업용 AI(인공지능) 개발 스타트업 사이오닉에이아이가 문서 추출 AI 모델 '페퍼OCR-VL'로 다국어 문서 추출 벤치마크 'MDP벤치'의 한국어·태국어 부문 1위를 기록했다고 10일 밝혔다. 두 언어 1위는 이달 5일 기준이다.
문서 추출은 기업이 사내 문서를 마크다운(Markdown) 등 AI가 처리할 수 있는 형태로 변환하는 작업을 말한다. 이 과정에서 표와 수식, 문단의 읽기 순서가 제대로 반영되지 않으면 검색과 답변 품질에도 영향을 미친다.
사이오닉에이아이가 개발한 문서 추출 AI '페퍼OCR-VL'은 문서, 청구서, 논문 등의 스캔·촬영 이미지에서도 표와 수식을 인식하고, 읽기 순서와 문서 구조를 반영해 문서로 변환한다. 45억개 파라미터를 가진 모델로, 그래픽처리장치(GPU) 한 장에서 구동되며, 중국어 간체자·번체자 포함 17개 언어를 지원한다.
페퍼OCR-VL은 지난 10월 4일 MDPBench 공개 리더보드 등재 이후 11월 5일까지 한국어(92.6점)와 태국어(83.3점) 두 언어 모두 1위를 기록했다. 같은 날 기준 17개 언어 종합 점수는 비공개 평가 세트 85.7점으로 4위, 공개 평가 세트 82.3점으로 8위였다.
사이오닉에이아이는 페퍼OCR-VL을 허깅페이스에 'AGPL-3.0' 라이선스로 공개했다. 누구나 소스 코드 전체 공개 조건으로 상업적인 활용이 가능한 라이선스다. 별도의 상업용 라이선스도 제공한다.
사이오닉에이아이는 "기업이 AI를 업무에 활용하려면 다양한 형태의 문서를 정확하게 이해하고 처리하는 기술이 중요하다"며 "한국어뿐 아니라 아시아태평양 지역의 다양한 언어와 문서 환경에 대응할 수 있도록 모델을 지속해서 개선하겠다"고 밝혔다.