[이 기사에 나온 스타트업에 대한 보다 다양한 기업정보는 유니콘팩토리 빅데이터 플랫폼 ‘데이터랩’에서 볼 수 있습니다.]
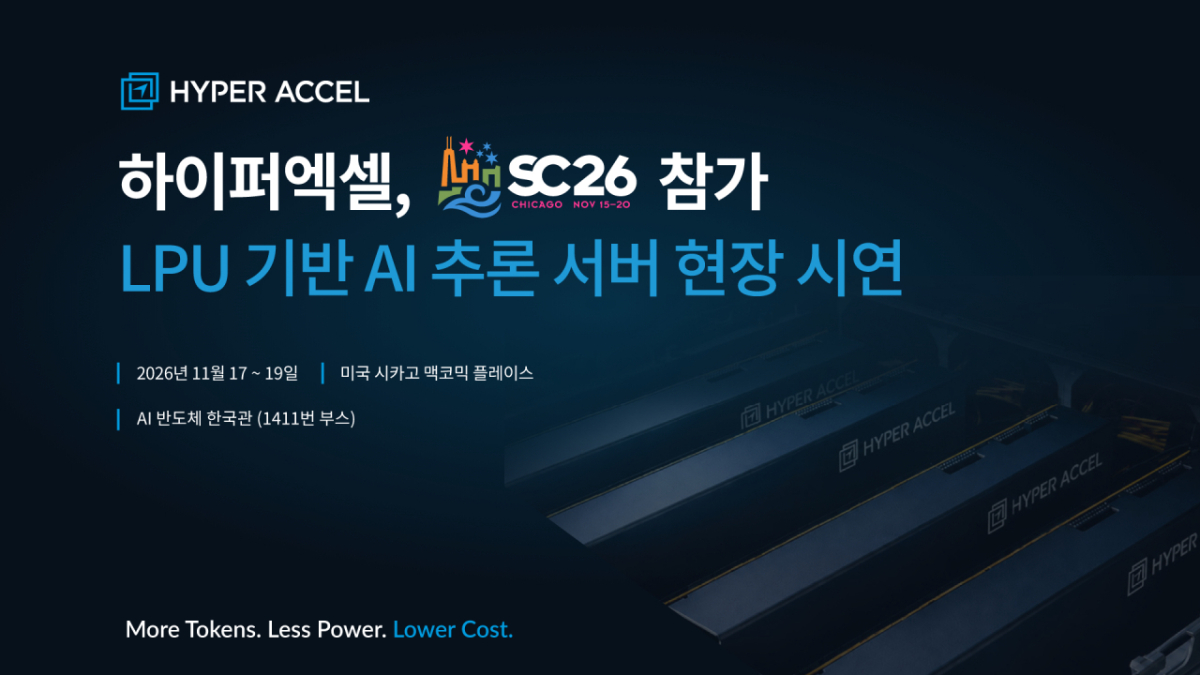
AI 반도체 스타트업 하이퍼엑셀이 오는 17일부터 19일까지(현지시간) 미국 시카고 맥코믹 플레이스에서 열리는 '슈퍼컴퓨팅2026(이하 SC26)'에 참가해 LPU(LLM(거대언어모델)처리장치) 기반 AI 추론 서버 시스템을 선보인다고 16일 밝혔다.
하이퍼엑셀은 이번 행사에서 LPU 8개를 탑재한 서버 시스템을 전시하고, 국내에서 실제 운영 중인 서버와 연결해 대규모 언어모델(LLM) 추론을 실시간으로 시연한다. 이를 통해 하이퍼엑셀 LPU의 추론 성능과 전력 효율을 현장에서 보여줄 계획이다.
하이퍼엑셀에 따르면, 이들이 개발한 LPU 카드 탑재 서버는 엔비디아의 RTX프로 6000 블랙웰 GPU(그래픽처리장치) 기반 시스템보다 와트당·달러당 토큰 처리량에서 3.5배 이상의 효율을 기록했다. 측정은 Qwen3-32B와 Llama3-70B 모델을 대상으로 진행했다. Kimi와 GLM 등 더 큰 규모의 LLM도 지원한다.
카드당 소비전력은 하이퍼엑셀 LPU가 250W로, 비교 대상 GPU의 600W보다 낮다. 하이퍼엑셀은 이를 바탕으로 대규모 LLM 추론 환경의 전력 소비와 운영 비용 부담을 보완할 수 있을 것으로 기대하고 있다.
하이퍼엑셀 LPU는 LPDDR(저전력D램) 메모리와 자체 개발 아키텍처를 결합해 메모리 대역폭 활용률을 높인 것이 특징이다. 메모리 대역폭 활용률은 약 90%로, 일반적인 GPU 기반 LLM 추론 환경에서 나타나는 약 50~60% 수준보다 높다. 메모리 병목을 줄여 LLM 추론의 데이터 처리 효율을 높이는 데 초점을 맞췄다.
하이퍼엑셀은 이번 SC26에서 글로벌 서버 제조사, 클라우드 서비스 제공업체(CSP), AI 인프라 기업 등을 대상으로 기술 검증과 협력 기회를 모색할 예정이다. 김준연 하이퍼엑셀 CFO(최고재무책임자)는 18일 행사장 내 래블업 부스에서 '토큰 효율로 재정의하는 AI인프라'를 주제로 발표도 진행한다.
김주영 하이퍼엑셀 대표는 "AI 도입이 가속화되면서 업계의 관심은 프로세서 성능을 넘어 대규모 AI 추론 환경에서의 효율성과 경제성으로 이동하고 있다"며 "이번 SC26에서 하이퍼엑셀의 토큰 처리 효율과 전력·비용 절감 가능성을 소개하고, 글로벌 인프라 파트너들과 협력 기회를 확대해 나가겠다"고 말했다.
독자들의 PICK
지금 7,276명 읽는 중