

김현우 엔비디아·KAIST AI 공동연구소장
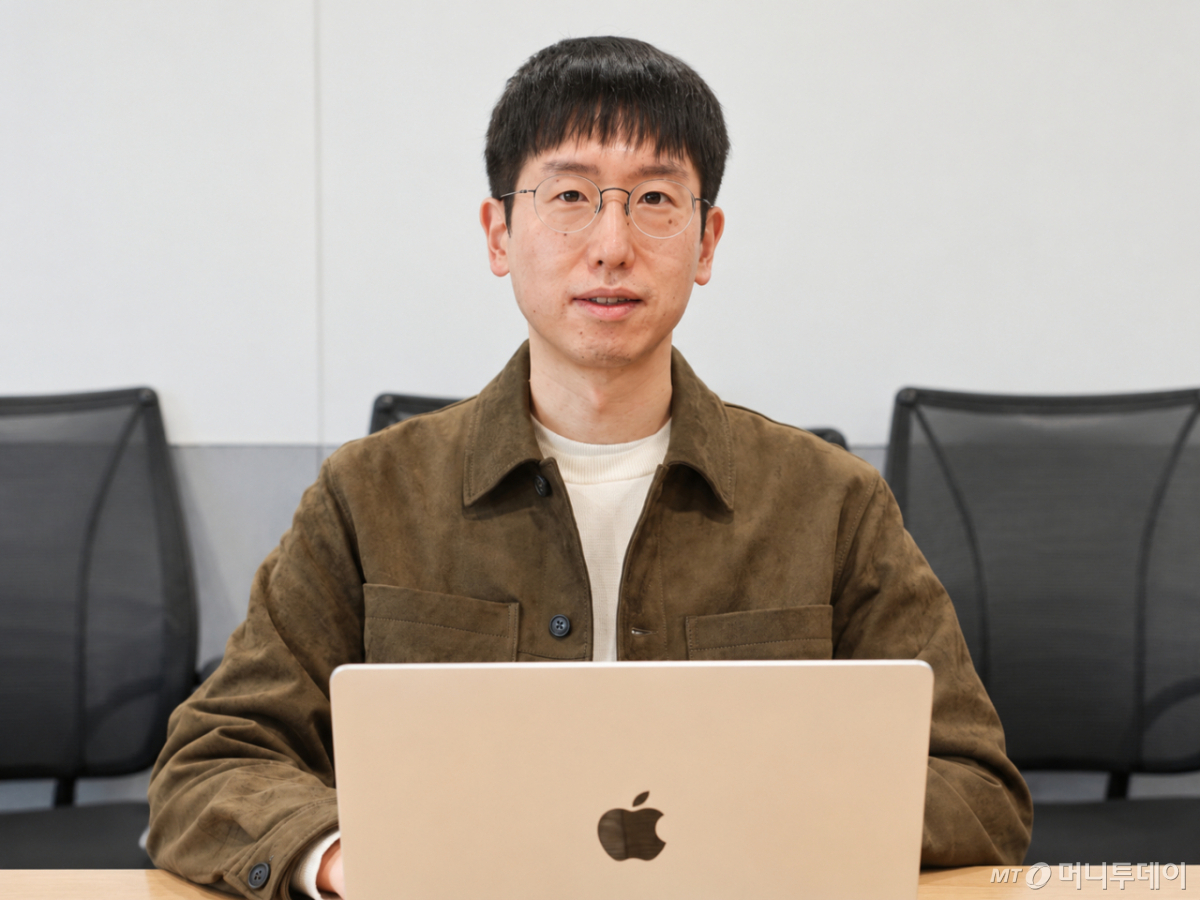
"좋은 나무 한 그루를 만들어 이식하는 게 아니라 숲을 만드는 법을 연구해 세계와 나누는 것이 목표입니다."
김현우 엔비디아·한국과학기술원(KAIST) AI(인공지능) 공동연구소장은 10일 서울 강남구 엔비디아코리아 사무실에서 진행한 인터뷰에서 이같이 말했다. KAIST 김재철AI대학원 조교수도 겸하는 김 소장은 특정 AI 모델이 아닌 여러 기업이 활용할 데이터와 학습 방법을 공개하겠다는 구상을 내놨다.
엔비디아와 KAIST는 7월 공동연구소 설립을 발표하고 첫 5년간 3억 달러(약 4032억원)를 투입하기로 했다. 1991년생인 김 소장은 "재밌는 프로젝트들이 준비돼 있어 내년 하반기쯤 다 공개가 되지 않을까 싶다"고 말했다.
연구의 두 축은 AI가 학습 데이터를 만들어내는 '합성 데이터' 기술과 기존 데이터에서 더 많은 내용을 배우는 학습 기술이다. 김 소장은 "인공지능에서는 GPU(그래픽처리장치)만큼이나 중요한 게 데이터"라며 "데이터 학습 노하우가 공개되지 않고 각 회사 내부에서만 공유되는 문제점이 있다"고 지적했다.
구글의 다국어 학습 데이터셋 'mC4'에서 영어 문서는 약 39억3000만건으로 한국어 문서 2400만건의 163배다. 지난달 기준 웹 문서 공개 아카이브 '커먼크롤'의 한국어 비중은 0.88%에 그쳤다. 김 소장은 "공개된 양질의 우리말 데이터셋을 찾기가 정말 어렵다"며 "모든 분야에서 부족하다"고 말했다.
김 소장은 엔비디아가 한국 연구소를 설립한 배경으로 KAIST의 연구 역량과 한국어의 특성을 꼽았다. 그는 "KAIST가 세계에서 굉장히 주목하는 학교가 됐다"고 말했다. 한국어는 영어·중국어보다 데이터가 적지만 소수 언어보다는 연구 기반이 갖춰진 '중간 자원 언어'에 해당한다. 그는 "한국어에서 출발해 다른 언어에도 적용할 수 있는 '오픈 레시피'와 데이터 학습 방법을 공개하겠다"고 밝혔다.
김 소장이 주도해 엔비디아가 4월 공개한 '네모트론 페르소나 코리아' 데이터셋은 허깅페이스에서 열흘간 인기 데이터셋 세계 1위를 기록하고 약 14만회 다운로드됐다. LG(90,400원 ▲700 +0.78%) AI연구원의 K-엑사원 2.5에도 활용됐다. 김 소장은 "네모트론도 숲의 여러 나무 중 하나"라며 연구 성과를 다른 AI 모델에도 적용하고 상업적으로 활용할 수 있도록 공개하겠다고 말했다.
전체 지원액 중 2억5000만달러는 컴퓨팅 자원으로 제공된다. GPU 종류와 수량은 아직 확정되지 않았다. 김 소장은 "국내 연구진들이 GPU 부족에 시달린다는 건 모두가 알고 있다"며 "엔비디아의 방대한 컴퓨팅 자원이 들어온다는 건 굉장히 단비와 같은 소식"이라고 했다.
독자들의 PICK
지금 1,984명 읽는 중
공동연구소는 매년 최소 10명의 KAIST 연구자를 지원하고 엔비디아 인턴십 기회를 제공한다. 정규 연구직 채용도 추진한다. 해외에서 근무하다 귀국한 김 소장은 "좋은 기회가 있기 때문에 돌아올 수 있다고 생각한다"며 "해외에 있는 우리나라 인재들을 우리나라로 불러오는 것도 큰 목표 중 하나"라고 강조했다.