

광운대학교는 박영재 교수 연구팀이 CJ그룹 AI/DT 추진실, 연세대학교, 광주과학기술원(GIST)과 함께 영화 시나리오와 실제 영상을 연결하는 새로운 장편 비디오 이해 평가 지표(벤치마크)를 구축했다고 14일 밝혔다.
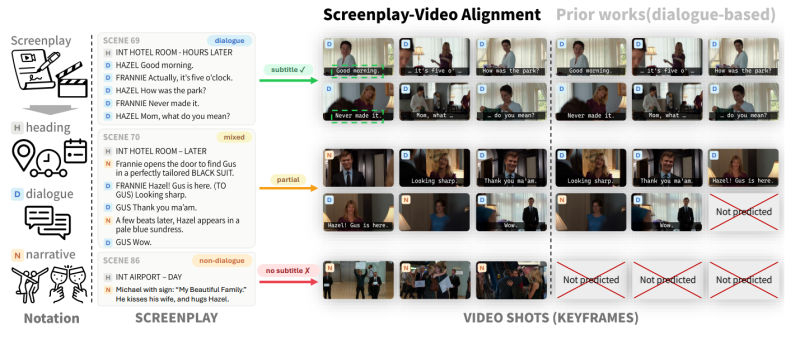
기존 AI 비디오 분석은 수십 초 내외의 짧은 영상과 간단한 텍스트를 연결하는 수준에 머물렀다. 영화처럼 복잡한 서사 구조를 가진 장편 영상의 경우, 대사가 없는 장면은 자막 위주의 매칭 방식이나 시각 정보만 단독으로 처리하는 AI 모델로는 온전히 파악하기 어려웠다.
연구팀은 영화 시나리오의 각 장면(Scene)을 실제 영상 샷(Shot)과 연결하는 '스크립트 투 샷'(From Script to Shot) 벤치마크를 개발해 이를 극복했다. 약 90년에 걸쳐 제작된 장편 영화 50편, 5만5000개 이상의 영상 샷을 사람이 직접 수작업으로 시나리오와 대조해 정렬 데이터를 구축했다.
14개의 AI 모델을 동일 조건에서 실험한 결과, 시각 정보만 활용하는 기존 모델의 한계를 넘어 대사 텍스트와 영상 시각 정보를 함께 결합한 멀티모달 융합 방식이 가장 우수한 성능을 냈다. 최신 비전-언어 모델(Qwen3-VL-Embedding)과 텍스트 검색(BM25)을 결합한 기법이 0.599 mSIoU를 기록하며 가장 높은 일치도를 보였다. 특히 대사가 있는 장면이 시간적 기준점 역할을 하며 주변의 비대사 장면 정렬까지 돕는 '대사 앵커링 효과'(Dialogue Anchoring Effect)가 확인됐다.
제안된 시나리오-영상 정렬 데이터는 별도 추가 학습 없이 영화 장면 분할에 곧바로 적용할 수 있다. 시나리오와 실제 장면의 대응 정보를 바탕으로 생성형 AI가 조명, 공간 구성, 색감 등을 반영한 정교한 영상 프롬프트를 작성하는 데도 쓰인다. 수 시간 분량의 장편 멀티모달 영상을 AI가 스스로 이해하고 분석하는 기반이 마련된 셈이다.
이번 연구 결과는 컴퓨터 비전 분야 최고 권위 국제학술대회인 'ECCV(European Conference on Computer Vision) 2026'에서 발표될 예정이다.