

구글·오픈AI·네이버 등 6개 LLM 분석… 전문가 자문·설문 대체 한계 입증
엔비디아 한국인 페르소나로 LLM 신뢰성 정밀 검증
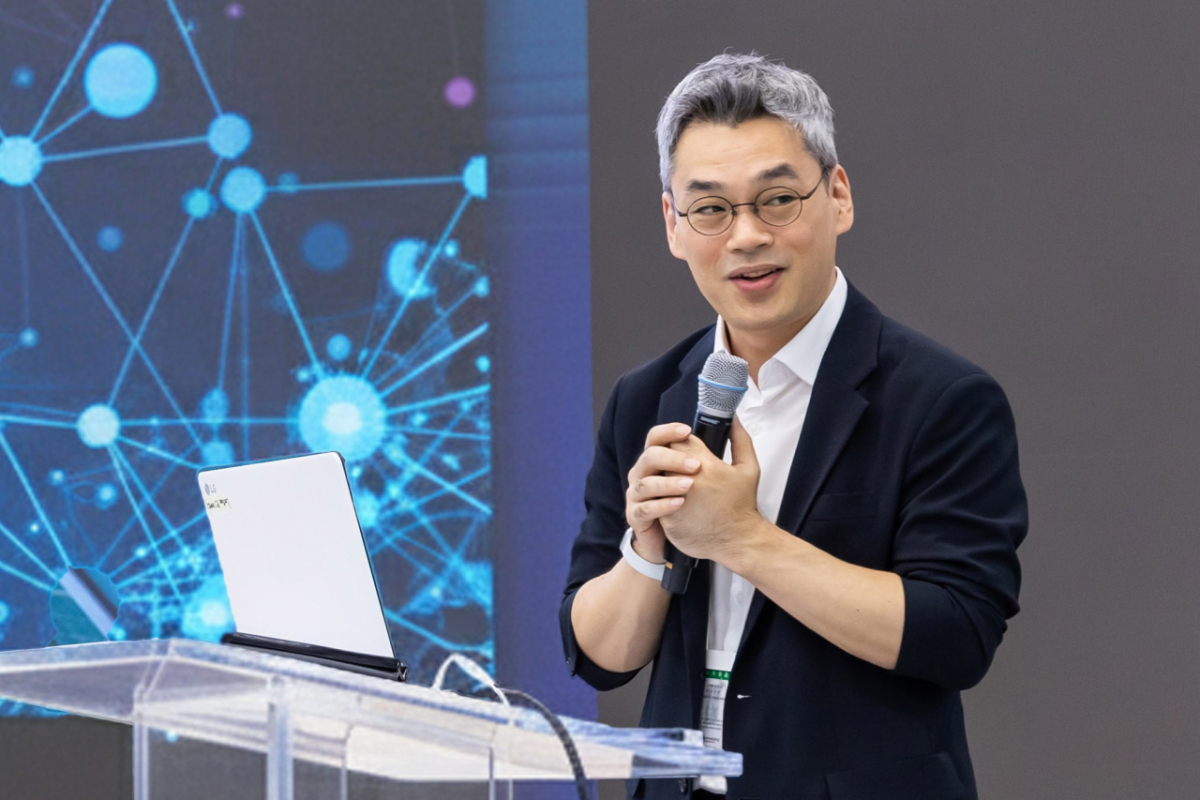
서울사이버대학교는 김환 AI융합대학 교수의 대규모 언어모델(LLM) 기반 'AI 합성 페르소나' 검증 연구 논문 2편이 국제학술지에 동시 게재됐다고 13일 밝혔다.
김 교수의 논문은 지난 1일자로 SSCI 등재 학술지인 '시스템즈'(Systems, IF 3.8, JCR 상위 25%)와 SCIE 등재 학술지 'IEEE 액세스'(IEEE Access)에 게재됐다.
'합성 페르소나'는 LLM에 나이, 성별, 지역 등 인구통계학적 특성을 입력해 만든 가상 응답자다. 최근 설문 조사나 전문가 자문을 가상 패널로 대체하려는 시도가 늘어나는 가운데, 김 교수는 이번 연구를 통해 생성형 AI의 응답 신뢰성과 통계적 한계를 실증적으로 분석했다.
Systems에 게재된 연구는 구글 Gemini, 오픈AI GPT, 앤트로픽 Claude, LG AI연구원 EXAONE, 네이버 HyperCLOVA X 등 6종의 LLM을 가상 전문가로 설정하고, 계층분석과정(AHP) 출판 연구 27편의 자문 결과를 재현하도록 설계됐다. 분석 결과 논문 제시 순서에 맞춰 중요도를 부여하는 단순 규칙이 6개 모델 전체의 예측력을 상회해, 모델 고유의 판단과 제시 순서 간 영향을 구분하기 어렵다는 점이 확인됐다.
IEEE Access 게재 논문에서는 엔비디아(NVIDIA)의 한국인 합성 페르소나 데이터셋 'Nemotron-Personas-Korea'를 활용했다. Gemini와 EXAONE에 해당 페르소나를 적용해 각 8000명 규모의 가상 패널을 구축한 뒤 정보통신정책연구원(KISDI)의 '한국미디어패널조사'를 재현한 결과 가상 패널의 응답은 실제 조사 수치와 평균 14~19%포인트의 유의미한 오차를 나타냈다.
김 교수는 "생성형 AI의 응답이 표면적으로 정교하더라도 실제 인간의 판단을 완전히 대체하기에는 한계가 명확하다"며 "LLM 출력물의 검증 역량을 강화할 수 있도록 연구 결과를 대학원 AI융합기술학과 및 AI융합대학 교육과정에 반영할 것"이라고 말했다.