

AI(인공지능) 추론 최적화 기업 노타(12,130원 ▲430 +3.68%)가 중국 문샷AI의 초거대 AI 모델 '키미 K3.1 프로(Kimi K3.1 Pro)'를 경량화해 GPU(그래픽처리장치) 구매비용을 최대 20% 절감할 수 있는 기술을 구현했다고 10일 밝혔다.
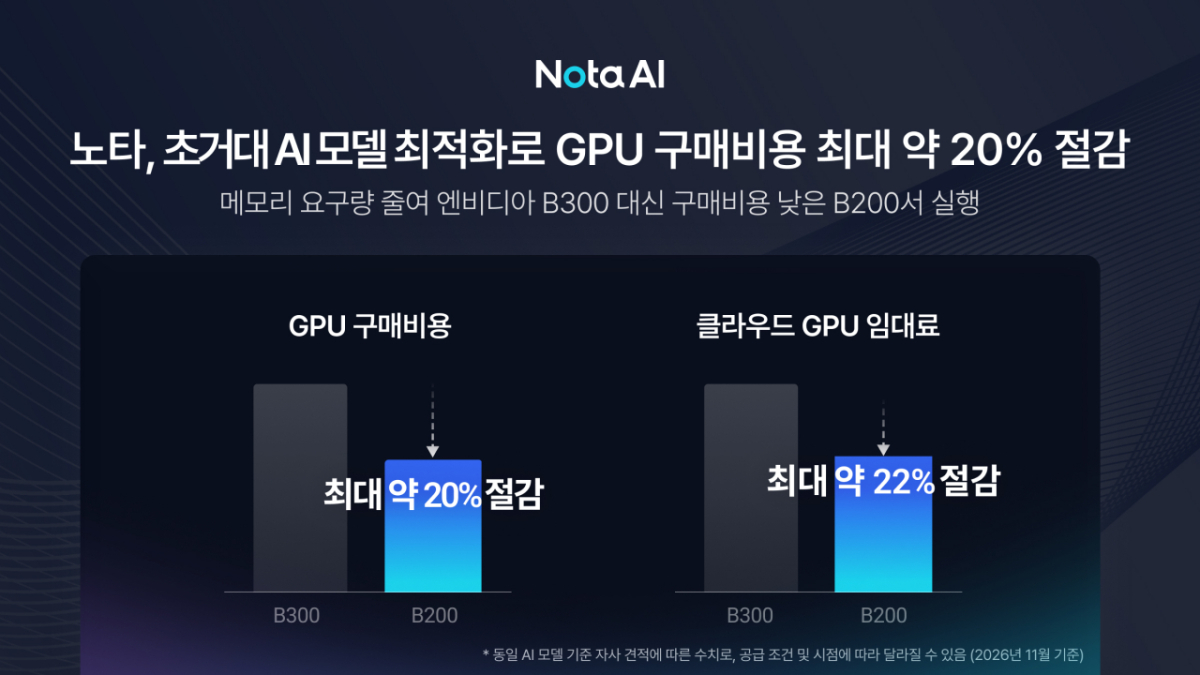
노타에 따르면 기존에는 엔비디아의 고성능 GPU인 B300 8장이 필요했던 모델을 상대적으로 가격이 저렴한 B200 GPU 8장에서도 구동할 수 있도록 최적화했다. 노타의 자체 견적 비교 결과, B300 대신 B200을 활용하면 GPU 초기 구매비용을 최대 약 20% 줄일 수 있다.
클라우드 환경에서도 B200 GPU 임대료가 최대 약 22% 낮은 것으로 나타났다. 이를 통해 기업들은 기존 B200 기반 인프라를 활용하거나 신규 GPU 도입에 따른 비용 부담을 줄일 수 있게 됐다.
키미 K3.1 프로는 2조8000억개의 매개변수를 갖춘 초거대 AI 모델이다. 노타에 따르면 전체 매개변수 기준 공개된 오픈웨이트 AI 모델 중 최대 규모다. 모델 규모가 클수록 실행에 필요한 메모리와 GPU 자원이 늘어나는 만큼, 주요 성능을 유지하면서 하드웨어 요구 사양을 낮추는 것이 핵심 과제로 꼽힌다.
노타는 AI 모델 내부에서 상대적으로 중요도가 낮은 신경망을 선별적으로 제거하는 '프루닝(Pruning)' 기술을 적용했다. AI가 질문에 답할 때 활용하는 여러 신경망 중 일부를 덜어내 모델의 크기를 줄이는 방식이다. 이를 통해 모델 내부의 '전문가 모듈'을 최대 37% 줄여 GPU 메모리 사용량을 낮췄다. 고난도 과학 추론 능력을 평가하는 'GPQA 다이아몬드'에서는 원본 모델 점수의 99% 이상을 유지했다.
메모리 사용량이 줄면서 한 번에 처리할 수 있는 정보량도 늘어났다. B200 GPU 8장 환경에서 전문가 모듈을 30% 줄인 모델은 최대 51만2000토큰, 37% 줄인 모델은 최대 100만토큰의 문맥을 처리할 수 있다. 토큰은 AI가 텍스트와 코드를 처리하는 기본 단위로, 처리 가능한 토큰 수가 많을수록 더 많은 정보를 한 번에 분석할 수 있다.
답변 생성 속도를 높이는 기술도 적용했다. 노타는 확보한 여유 메모리를 활용해 작은 보조 모델이 답변을 미리 생성하고 본 모델이 이를 검증하는 '추측 디코딩(Speculative Decoding)' 기술을 지원하도록 했다.
노타는 앞서 키미 K3 모델을 경량화해 구동에 필요한 B300 GPU 수를 기존 8장에서 최대 4장으로 줄인 바 있다. 이번에는 후속 모델인 키미 K3.1 프로의 구동에 필요한 GPU 사양을 낮추는 방식으로 최적화 범위를 확대했다.
독자들의 PICK
지금 755명 읽는 중
채명수 노타 대표는 "AI 산업의 경쟁력은 더 많은 고성능 GPU를 확보하는 것뿐 아니라 이미 보유한 컴퓨팅 자원에서 얼마나 높은 성능과 효율을 구현하느냐에 달려 있다"며 "이번 성과는 초거대 AI 모델의 주요 추론 성능을 유지하면서 하드웨어 요구 조건을 낮춰 AI 도입의 경제성을 개선할 수 있음을 보여준다"고 말했다.
한편 노타가 경량화한 키미 K3.1 프로 모델은 글로벌 AI 플랫폼 허깅페이스에서 확인할 수 있다.