

엔비디아의 차세대 AI(인공지능) 플랫폼 '베라 루빈 NVL72'가 실제 AI 에이전트 작업을 재현한 벤치마크에서 현행 'GB300 NVL72' 대비 전력당 처리량이 최대 30배 높은 것으로 나타났다.
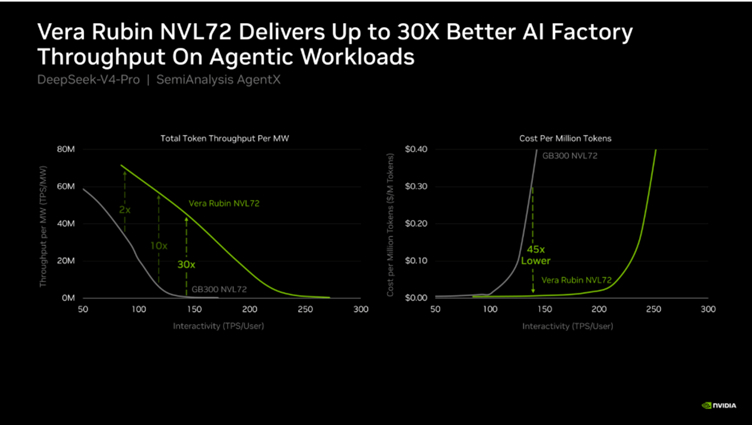
16일 엔비디아에 따르면 AI·반도체 분석업체 세미애널리시스의 '에이전트X'에서 딥시크 V4 프로 모델을 구동한 결과 베라 루빈 NVL72의 MW(메가와트)당 처리량은 GB300 NVL72 대비 최대 30배 높았다. 100만 토큰당 비용도 최대 45분의 1 수준으로 낮아졌다.
에이전트X는 기존 AI 벤치마크와 달리 실제 기록된 에이전틱 코딩 세션을 기반으로 추론 성능을 측정한다. AI가 질문에 한 차례 답하는 데 그치지 않고 스스로 추론하고 외부 도구를 호출하거나 하위 에이전트를 생성하는 과정까지 반영한다.
AI 에이전트는 작업을 이어가며 이전 대화와 작업 내용을 계속 참고하기 때문에 처리해야 할 데이터가 빠르게 늘어난다. 한 세션에서 수십만개의 입력 토큰이 쌓일 수 있으며, 단순 채팅보다 사용하는 토큰이 약 15배 많다는 게 엔비디아의 설명이다.
이 때문에 전력 효율이 중요하다. 데이터센터가 쓸 수 있는 전력이 제한된 상황에서 같은 전력으로 더 많은 AI 작업을 처리할수록 운영 효율과 수익성을 높일 수 있다.
다만 최대 30배라는 수치가 모든 환경에서 동일하게 나타나는 것은 아니다. 엔비디아가 공개한 자료에 따르면 딥시크 V4 프로 기반 에이전트X에서 사용자당 초당 160토큰의 응답 속도를 기준으로 비교했을 때 최대 30배 차이가 났다. 실제 성능 격차는 모델과 응답 속도, 소프트웨어 구성 등에 따라 달라질 수 있다.
엔비디아는 성능 향상의 배경으로 72개 GPU(그래픽처리장치)를 하나의 시스템처럼 연결하는 NVL72 구조와 6세대 NV링크, 5세대 텐서 코어의 NVFP4 연산, 텐서RT LLM·다이나모 등 소프트웨어 최적화를 꼽았다.