


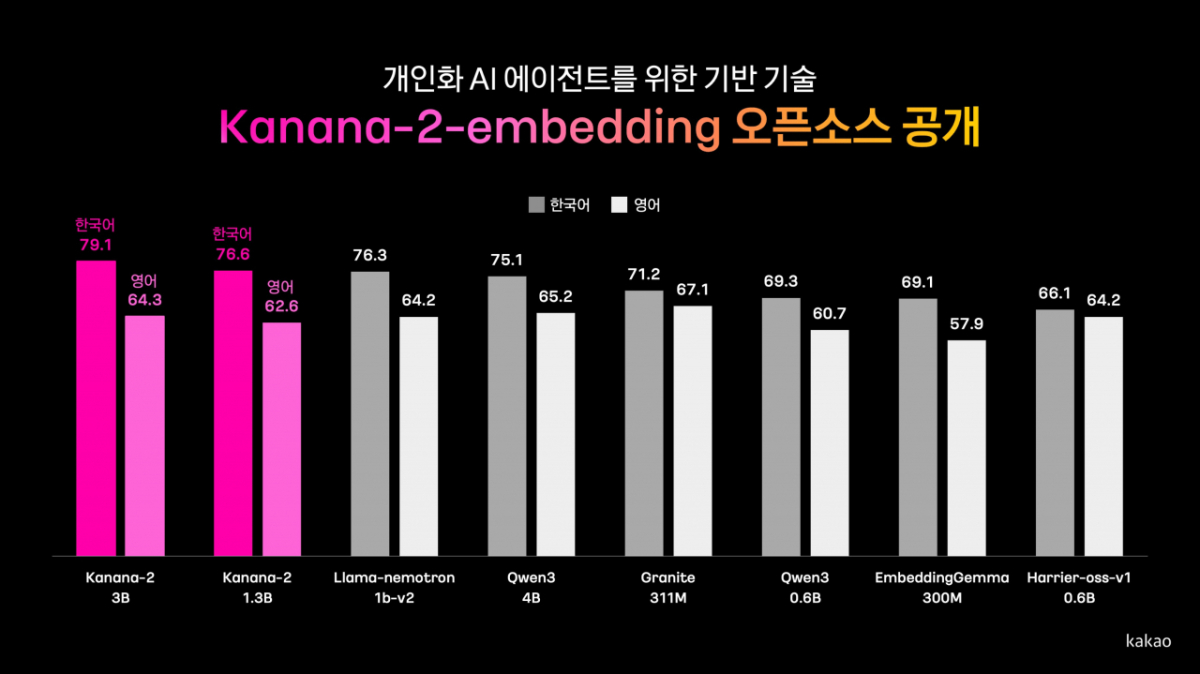
카카오(29,250원 ▼550 -1.85%)가 정확한 단어를 기억하지 못하는 이용자에게 비슷한 의미의 정보를 검색해 제공하는 AI(인공지능) 기술을 오픈소스로 공개했다.
카카오는 개인화 AI 에이전트의 기반 기술인 임베딩(embedding) 모델 '카나나-2-임베딩' 2종을 허킹페이스에 오픈소스로 공개했다고 29일 밝혔다.
공개된 모델은 30억 파라미터 규모의 △Kanana-2-3b-embedding과 13억 파라미터 규모의 △Kanana-2-1.3b-embedding으로, 지난 7월 카나나 소형 언어모델(SLM) 4종에 이은 추가 오픈소스 공개다. 공개한 임베딩 모델 2종은 유사 규모의 공개 임베딩 모델 'llama-nemotron-embed-1b-v2'나 'Qwen3-Embedding-4B'와 비교한 평가에서 가장 높은 한국어 성능과 유사한 수준의 영어 성능을 보였다. Qwen3-Embedding 대비 추론 효율도 높았다.
임베딩 모델은 텍스트의 의미를 수치로 표현해 이용자의 질문과 관련된 정보를 찾는 기술이다. 일반 언어모델이 질문을 이해하고 답변을 생성한다면, 임베딩 모델은 질문과 정보 사이의 의미적 유사성을 바탕으로 답변에 필요한 정보를 찾아주는 역할을 한다. 예를 들어 이용자가 "전에 이야기했던 조용한 식당이 어디야"라고 물으면 식당 이름을 입력하지 않아도 '대화하기 좋은 곳'처럼 비슷한 의미로 남아 있는 과거 정보를 찾도록 도와준다.
카카오는 자체 소형 언어모델 'Kanana-2-SLM'의 언어 이해 능력을 정보 검색에 활용할 수 있도록 학습시켜 3B 모델을 개발했다. 이어 큰 모델이 학습한 정보를 작은 모델에 전달하는 지식 증류 기법을 적용해 1.3B 모델을 구축했다.
카카오는 서비스 운영 환경에 맞춰 효율을 조정할 수 있는 기술도 적용했다. 텍스트의 의미를 숫자들의 묶음으로 표현한 '임베딩 벡터'에서 사용하는 숫자의 개수를 조절할 수 있는 'MRL(Matryoshka Representation Learning)' 기법을 도입했다. 개발자는 서비스에 필요한 검색 성능, 저장 공간, 처리 속도 등을 고려해 벡터의 크기를 선택할 수 있다.
두 모델에는 연구·개발뿐 아니라 라이선스 조건에 따른 상업적 활용도 가능한 '카나나 오픈 라이선스(Kanana Open License)'를 적용했다. 국내외 연구자와 기업은 공개된 모델을 직접 검증하고, 개인화 기반의 AI 에이전트와 의미 기반 검색 서비스 개발에 활용할 수 있다. 카카오는 앞으로 더 큰 언어모델을 기반으로 임베딩 학습과 지식 증류 연구를 이어가며, 검색 성능과 활용 효율을 함께 높인 모델을 개발할 계획이다.
독자들의 PICK
지금 4,824명 읽는 중
노병석 카카오 유니파이드 파운데이션 모델 성과리더는 "AI 에이전트가 이용자에게 필요한 도움을 제공하려면 질문에 답하는 능력과 함께 흩어진 정보 속에서 필요한 정보를 찾아내는 기술이 중요하다"며 "연구자와 개발자가 한국어에 강점이 있는 임베딩 기술을 다양한 서비스에 활용할 수 있도록 돕겠다"고 말했다.

