

국내 AI(인공지능) 최적화 기업 노타가 AMD 프로세서에서 GPU(그래픽처리장치)와 NPU(신경망처리장치)를 함께 활용해 AI 모델의 추론 성능을 최대 30% 개선했다. AI 에이전트가 최적화 작업을 자동으로 수행하는 방식으로 메모리 사용량과 전력 소모도 줄였다.
김태호 노타 CTO(최고기술책임자)는 4일 서울 강남구 웨스틴 서울 파르나스 호텔에서 열린 'AMD Advancing AI World Tour Seoul 2026'에서 이 같은 협력 사례를 공개했다. 노타는 AI 모델 최적화 플랫폼 '넷츠프레소'를 개발한 기업이다. 최근에는 AI 에이전트가 모델과 실행 소프트웨어를 분석해 최적화 작업을 수행하는 기술을 개발하고 있다.
김 CTO는 "AI 모델을 만드는 사람들은 자신의 모델이 어떤 NPU에서 구동될지 생각하면서 개발하지 않는다"며 "하드웨어 역시 다음 주에 어떤 AI 모델이 나올지 예측하고 만들 수는 없다"고 말했다. 이어 "이러한 간극을 줄이는 것이 우리가 하는 일"이라고 설명했다.
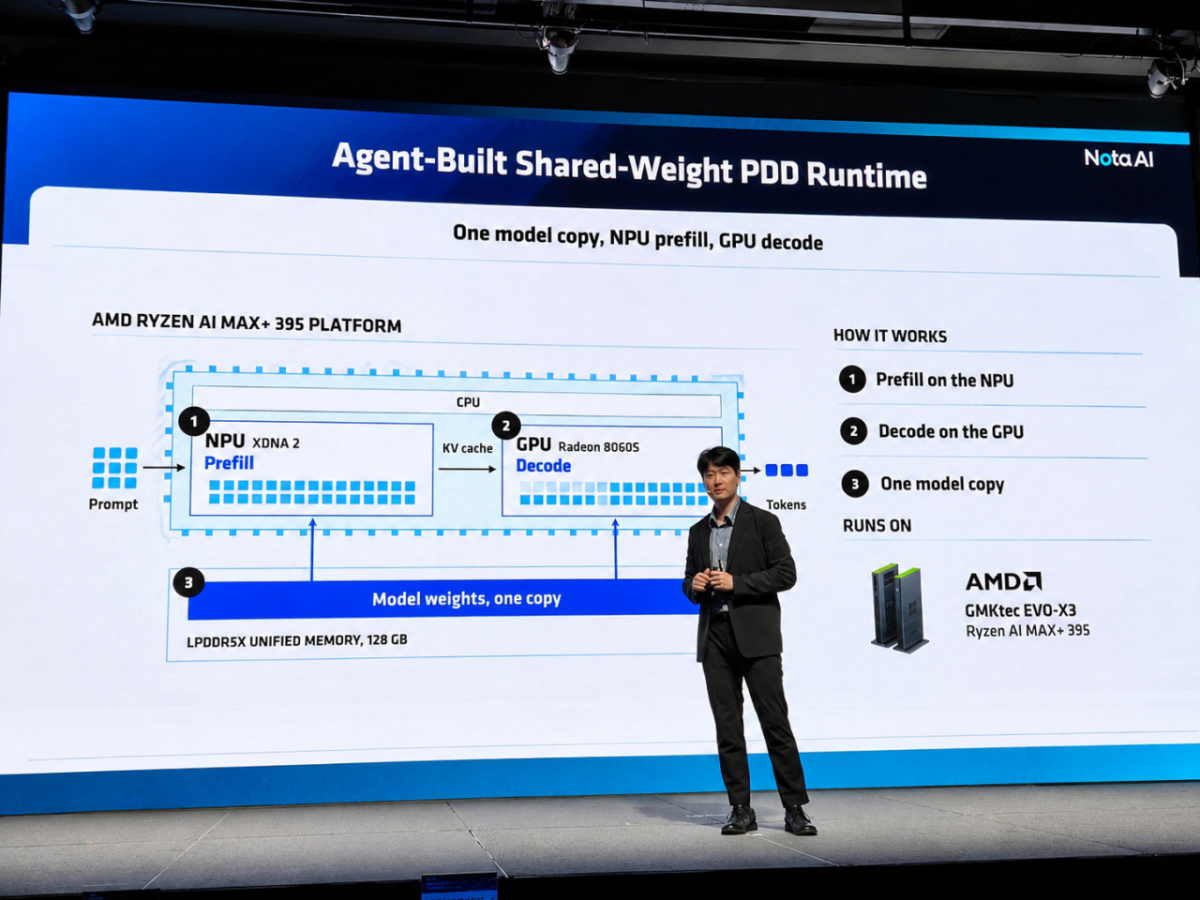
이번에 공개한 사례는 AMD의 '라이젠 AI 맥스+ 395' 프로세서를 활용한 온디바이스 AI 최적화다. 노타는 AI 모델이 입력 정보를 처리하는 '프리필' 작업을 NPU에, 답변을 생성하는 '디코드' 작업을 GPU에 각각 배분했다. 일반적으로 두 장치에 작업을 나누면 AI 모델을 별도로 저장해야 해 메모리 사용량이 늘어날 수 있다. 노타는 이를 하나의 모델로 통합해 중복 저장 문제를 해결했다.
김 CTO는 "프리필과 디코드를 NPU와 GPU에 나눠주면 모델을 두 개 갖고 있어야 하고 메모리도 두 배로 필요하다"며 "메모리가 금값인 시대에 이를 두 배로 활용하는 것은 용납하기 어렵다"고 말했다.
특히 AI 에이전트가 모델과 실행 소프트웨어 등을 분석해 최적화 대상을 결정하고 성능 개선 작업을 반복하도록 했다. 김 CTO는 "코드가 문제인지, 실행 소프트웨어가 문제인지, 모델이 문제인지 에이전트가 스스로 판단하고 최적화한다"고 설명했다.
노타는 라마, 큐웬, 파이, 미스트랄 등 여러 AI 모델에 이 기술을 적용한 결과 기존 대비 약 11~30%의 성능 개선 효과를 확인했다고 밝혔다. NPU의 낮은 전력 소비 특성을 활용해 토큰당 에너지 사용량도 줄였다는 것이다.
노타는 AMD와의 협력을 기업 내부 서버와 클라우드, 피지컬 AI 영역으로 확대할 계획이다. 김 CTO는 "휴머노이드 로봇의 두뇌가 클라우드에 있다면 굉장히 불안할 것"이라며 "네트워크가 끊어졌다고 로봇이 쓰러져서는 안 되는 만큼 AI 모델이 기기 내부에서 작동해야 한다"고 설명했다.