딥시크 개발비 절감 비결
학계 "학습과정 등은 검증 필요"
중국 AI(인공지능) 스타트업 '딥시크(DeepSeek)'가 챗 GPT보다 개발 비용이 낮으면서 성능은 유사한 이른바 '고효율' AI를 내놓은 배경엔 학습 과정에서의 비용 절감이 큰 역할을 한 것으로 분석된다. 다만 과학기술계는 "딥시크가 공개한 오픈소스를 바탕으로 실제 기술력을 검증 중"이라며 신중한 접근을 강조했다.
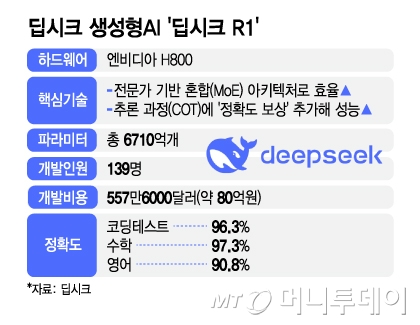
31일 과학기술계에 따르면 딥시크가 최근 공개한 AI 모델 'R1'의 낮은 개발 비용엔 'MoE(Mixture-of-Experts)' 아키텍처가 중요한 역할을 했을 것으로 추정된다. '전문가 혼합'이라는 뜻의 MoE는 특정 분야의 여러 전문가가 모여 각자 작업을 수행하듯, 특정 작업에 특화된 여러 LLM(거대언어모델)을 한데 모은 뒤 작업의 종류에 따라 필요한 LLM만 활성화하는 기술이다.
딥시크가 공개한 기술보고서에 따르면, 딥시크-R1의 파라미터(매개변수)는 6710억개에 이르지만, 작업 시엔 이 중 340억개만 선별적으로 활성화하도록 설계됐다. 모든 매개변수를 한 번에 사용하지 않기 때문에 기존 메커니즘보다 메모리 사용량이 훨씬 낮고 작업 속도도 빠르다. 딥시크는 이를 통해 R1과 비슷한 수준의 챗PGT-o1보다 메모리 사용량을 90%까지 줄인 것으로 알려졌다.
안성수 KAIST(카이스트) AI 대학원 교수는 "작업마다 특화된 소규모의 '전용 LLM'만 활성화해 AI 학습 비용을 절감하는 게 MoE의 장점인데, 딥시크가 지난해 말 딥시크-V3에서 선보인 기술을 이번 R1에도 적용한 것으로 보인다"며 "지난해부터 연구 결과가 대거 나오기 시작한 기술인데 (딥시크가 먼저) 성능을 끌어낸 것 같다"고 봤다.
"오픈AI 학습 데이터 무단 사용?…실제라면 총 개발비 늘어나"
다만 딥시크가 '지도 학습(Supervised Fine-Tuning)'을 줄이고 '강화 학습(Reinforcement Learning)'에 집중해 성능을 높였다는 분석에 대해선 "(학계·산업계 차원의) 검증이 필요하다"는 시각이 나온다.
지도 학습은 AI 모델이 특정 작업을 수행할 수 있도록 추가로 학습시키는 기술이다. 강화 학습은 AI가 스스로 답을 찾을 수 있도록 추론 능력을 향상하는 기술이다. 강화 학습에 집중한다는 건 학습을 '덜' 시켜도 추론을 통해 정답을 찾을 수 있는 AI를 만든다는 의미다. 이를 통해 학습 과정에 드는 비용을 최소화한다는 것이다. 딥시크는 AI가 추론을 통해 정답을 찾았을 때 가점을 부여하는 '정확도 보상(Accuracy Rewards)'을 적용해 성능을 높인 것으로 알려졌다.
정송 KAIST AI대학원장은 "(딥시크의 주장처럼) AI의 학습 과정을 추론 과정으로 대체했다고 하더라도 대체 과정에서의 개발 비용이 만만찮을 텐데, 이 부분에 대해선 명쾌한 설명이 아직 없는 상황"이라고 했다. 또 "추론을 하려면 이를 판단할 사전 지식이 있어야 하는데, 만약 이 과정에서 자체 개발한 학습 데이터가 아닌 타사의 학습 데이터가 들어갔다면 총 개발 비용에 학습 데이터 이용료도 포함됐어야 했을 것"이라고 했다. 이 경우 딥시크-R1의 총 개발비가 현재 공개한 558만달러(약 78억원)보다 높아질 수 있다고 보는 것이다. 오픈AI는 자사 AI 학습 데이터를 딥시크가 불법으로 사용했다고 주장하고 있다.
독자들의 PICK
지금 1,148명 읽는 중
이경하 KISTI(한국과학기술정보연구원) 초거대AI연구단장은 "딥시크가 R1의 소스와 테크니컬 리포트(AI의 세부 정보를 소개하는 논문)를 모두 공개한 만큼, 딥시크가 제시한 사양으로 성능을 재현할 수 있을지에 대한 검증이 이뤄지고 있다"고 했다. AI 오픈소스 플랫폼 '허깅페이스'의 R1 개발 코드 다운로드 횟수는 31일 기준 49만회에 이른다. 이 단장은 "딥시크가 진짜 AI 계의 '돌파구'가 될지는 검증을 마친 후 확언할 수 있을 것"이라고 덧붙였다.